
目次
2024年6月、まったく、なんの前触れもなく、本業の解雇を言い渡された。
「日本の全ビジネスはパートナー企業に移管、組織をスリム化する。今日から君は働かなくていい。条件は人事と調整してくれ。」
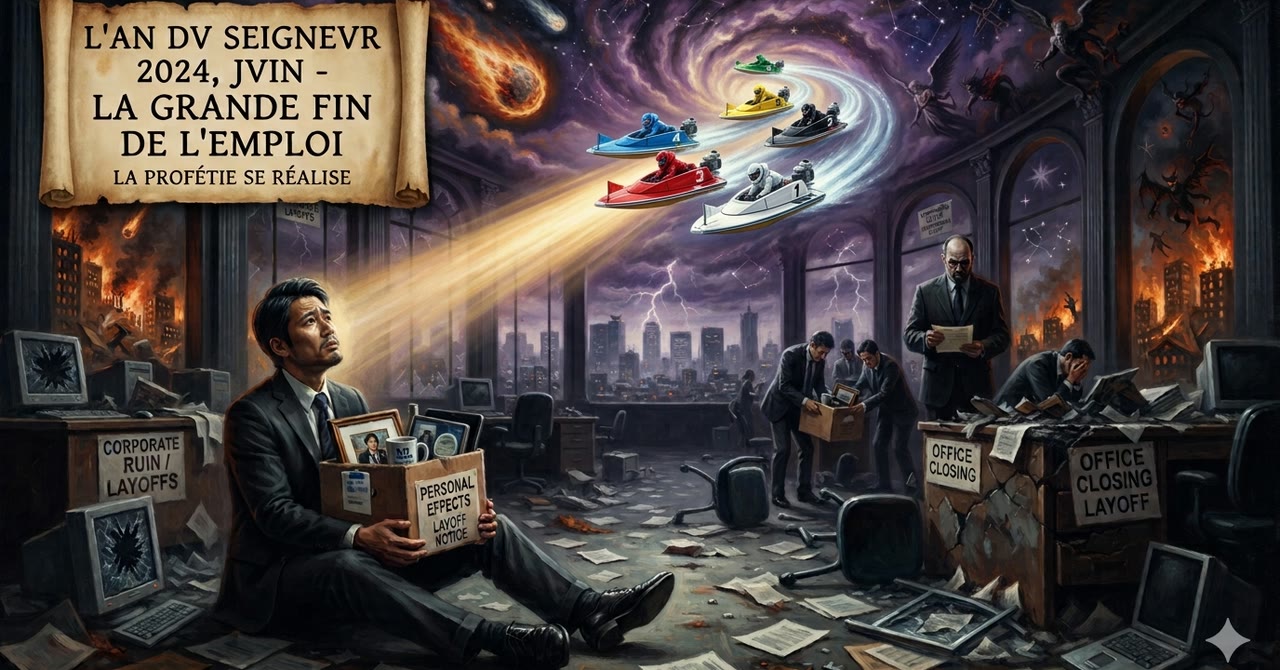
この件についてはあまり語りたくない。(多少大げさに)AIに描いてもらった上の絵のとおりである。意図せず、競艇予想の研究が本業になってしまった。
ハローワークへ急げ
予想の話の前に、もう少し僕の失業経験を共有しておく。会社都合の場合の失業保険※1 ※2についてである。
まず、離職票を早く会社に発行してもらうこと。待っていてはいけない。催促すること。そして、手元に離職票が届いたらその日にハローワークで手続きすることである。
よく言われる日本の行政システムの闇である。税金は自動で徴収・催促されるが、給付金は自分から申請しないと得ることができない。そして失業保険は申請した日を起点として支給されるのだ。自分の生活を守るには自ら動くしかない。
そして、失業保険は2000年頃から給付の上限が相当下げられている。これまで失業したことがない方は、現在の給料の何割という考え方ではないことに注意したほうがいい。ある程度の期間、企業に勤めていた方にとっては、月あたりの支給上限は圧倒的に低く感じることだろう。
研究を続けるにはAWS課金(当時最大で約15,000円/月)をなんとかしなければならないが、僕の頭はいまだ予想的中の希望の光に包まれている...。失業中なのに。
予想の話に戻ろう。
二兎の前のもう一匹
前回の終わりに、「春先から、この大穴モデルを運用しつつ、3連単予想モデル(=クラス分類モデル)の構築という二兎を追い始める。」と書いたが、改めて GitHub を確認してみると記憶と違っていた。
僕はまず、DeepSAD モデルと同じことを LightGBM※3 でも確認(大穴かどうかの2値分類)していたようだ。
LightGBM では、DeepSAD と同じ特徴量を入力にしつつ、閾値 48,000円 → 24,000円 → 12,000円と大穴の定義を変えてモデルの精度を比較していた。
LightGBM は、DeepSAD(非GPU環境)と比べると圧倒的に学習速度が速い。課金にビビりながらも精度は下げたくないなと、精度もないのにさまよう失業者である。
結局、大穴予想としては LightGBM は却下し、ほんの少し精度が良かった(ほぼサイコロと同一レベルだが) DeepSAD にその後も学習させていた。(2026年現在はゴミ箱行き)
もう一つの兎 - TabNet 3連単予想
夏から(8月、失業から2ヶ月経ってもまだ就職先は見つかっていない) TabNet※4 ※5 モデルを新たに導入し、3連単の予想を実装した。
つまり、各レースで3連単の組合せ(1着-2着-3着)を予想するモデルを追加したのだ。
なぜ学習時間のかかる TabNet を選んでしまったのか。これは、DeepSADが精度が良かったため、PyTorch 系でテーブルデータ(=特徴量データ)が扱いやすいものを選んだためだ。
3連単の予想について説明する。当時の前提条件は以下である。
- 予想モデルは、各ボートレース場毎に学習する
- 予想は確率順に複数、利益がでる予想数を調査できるようにする
このとき僕は、いきなり120クラス(=3連単の全パターン)を予想するのはやめたほうがいいだろうと、ボートレースの素人ながら感じていた。問題は別とはいえ、大穴の2クラス分類(大穴かそれ以外か)でも難しいのだ。そこで、まず 2連単の30クラス分類(1-2, 1-3, ..., 6-4, 6-5)から挑戦した。
ただし、2連単ではリターンが低すぎるため、3連単でシミュレートする。当時利用していた Lambda 関数の名前に、800AR-assess-results-sum-all がある。800 とは、1レースあたり3連単を8パターン × 100円で、合計800円ベットするという意味だ。
各レース、確率の高い順に2つ(p1とp2)の2連単の予想を出力させ、3着は全ベット(4パターン)ということである。つまり、2連単の上位予想2つ × 3着として4パターン = 8パターン。
if ((first == p1_first and second == p1_second) or
    (first == p2_first and second == p2_second)):
    hit_count += 1
    profit_loss += san_ren_tan_pay - 800     # 的中: 3連単の実配当 − 投資
else:
    profit_loss -= 800                        # 外れ
つまり、以下のような2つのフォーメーションを作る。3着は、1着、2着の予想に出てこない数字を4パターン、3連単に賭けたとする。
〇-〇-全、□-□-全
1-4-全 であれば(1-4-2, 1-4-3, 1-4-5, 1-4-6 に賭けるということ)
1レースあたり 800円を上回る予想ができるだろうか?と、ここでまた問題にぶつかったのである。学習するデータが足りないのだ。
学習データが足りない
分類するクラスを増やすと、学習データが足りなくなる...。
例えば、この時点で児島ボートレース場のデータは 1,582レース分溜まっていた。しかし、このデータを30クラスに分けると、1-2 が 296件、6-5 が 3件しかない!
1年半分のデータを集めても、ほとんどの場で30クラスのうち約5クラス(6号艇が1着は稀)が「10件未満」で、学習データとしては乏しすぎる数しかないのである。ボートレースの面白い特徴ではあるが、1号艇が1着となる確率が高いことが学習データに歪みを与えている。
どうしてこうも問題ばかり発生するのか。思えばバブル崩壊後の氷河期、リーマンショック倒産、寝耳にレイオフなど、お楽しみアトラクションが次から次へと...である。
データを追加しなければならない。
データ不均衡への対応
ここで、少しだけ技術的な情報を記録しておく。ダイアナボートでは、過去から現在までさまざまな機械学習モデルを使って分析を行ってきた。ほとんどのモデルは weights ハイパーパラメータをサポートしている。各クラスの学習データが不均衡である場合、データが少ないクラスに重みを付けることができ、'balanced' などのオプションがある。当時はこの重み付けや Focal Loss などを相当試したが、いまは使っていない。
僕の研究では、ボートレース予想の場合は自然なクラス分布を利用したほうが良いようだ。つまり、weights をクラス毎に設定するようなことは行わない方が、良い結果が出ている。
※ あまりにも古い過去データは重みを下げる処理を行っている。クラス別で重みはつけないが、新しいデータ重視という設定は使用している。
当時のデータ状況
当時のデータ数がスクショで残っていた。
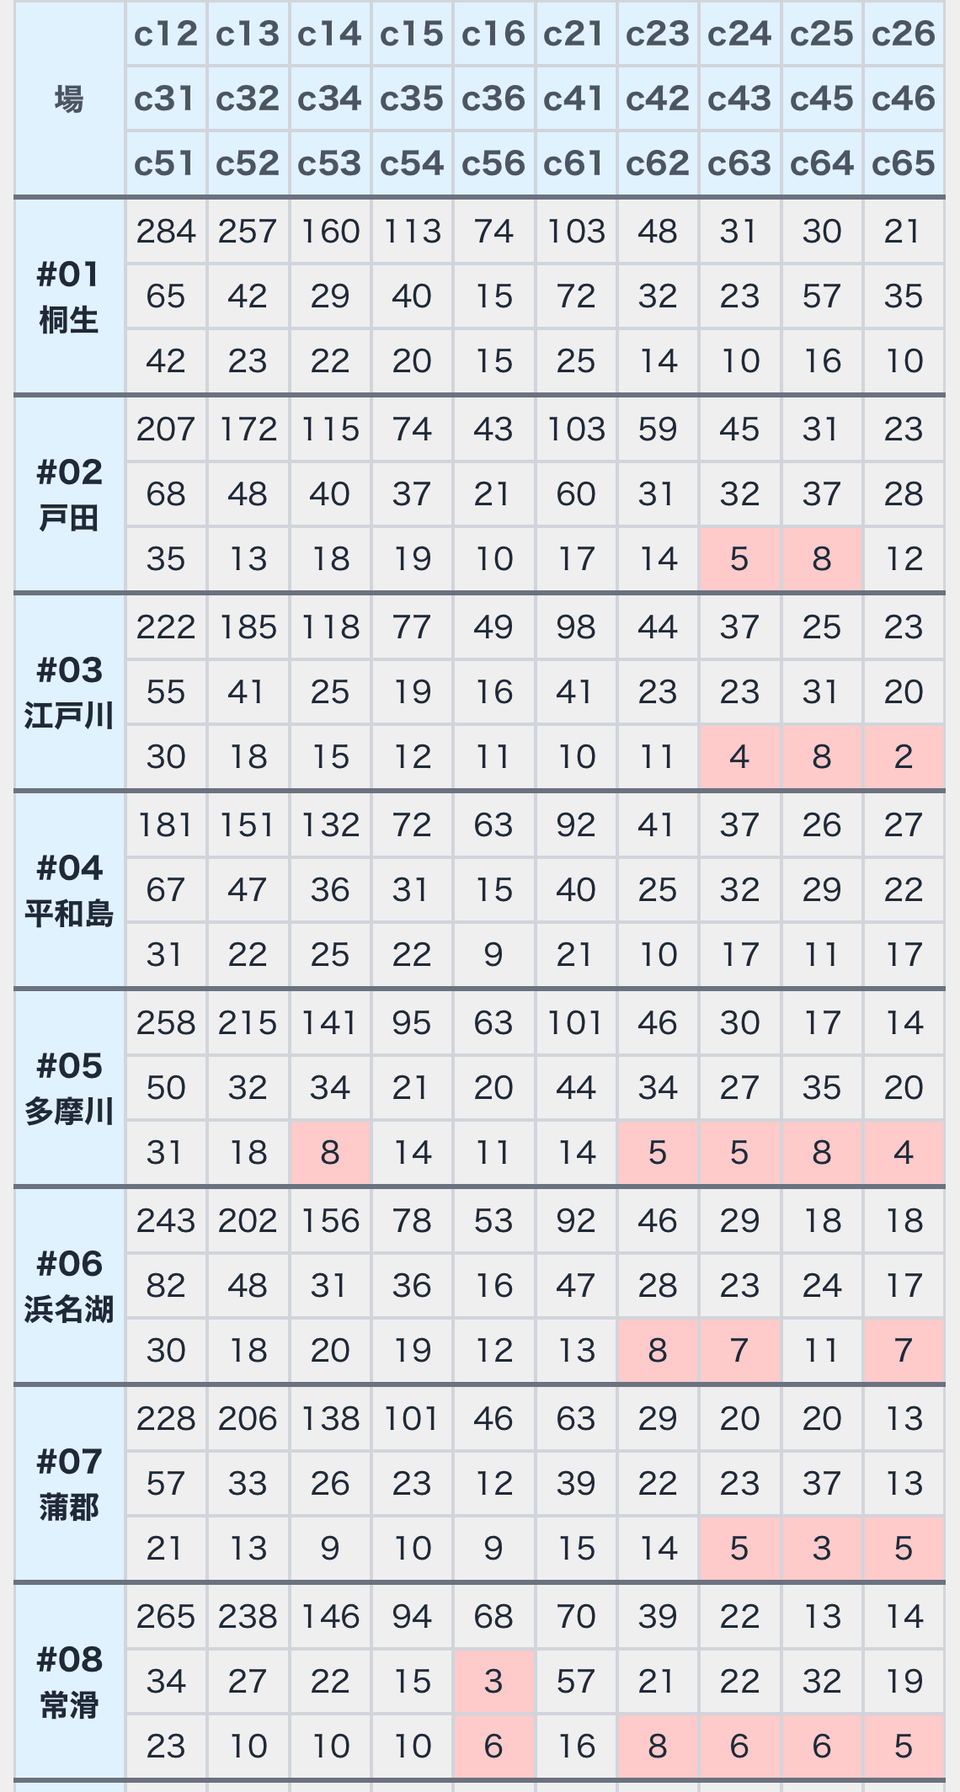
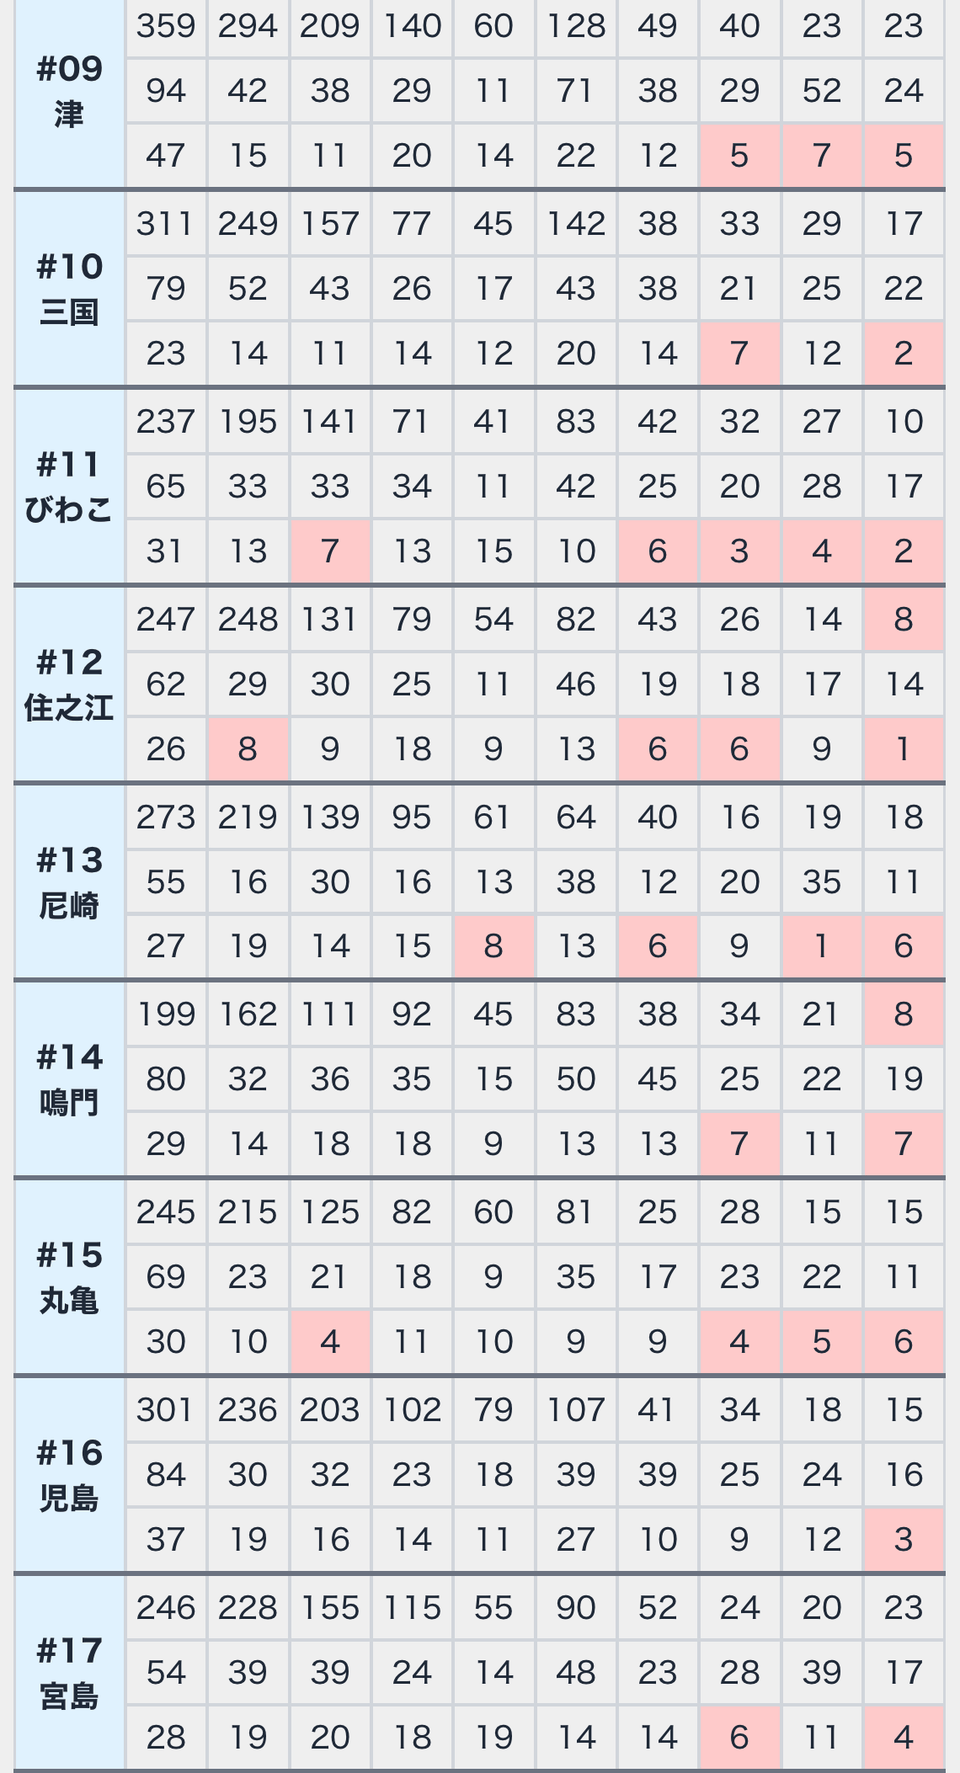
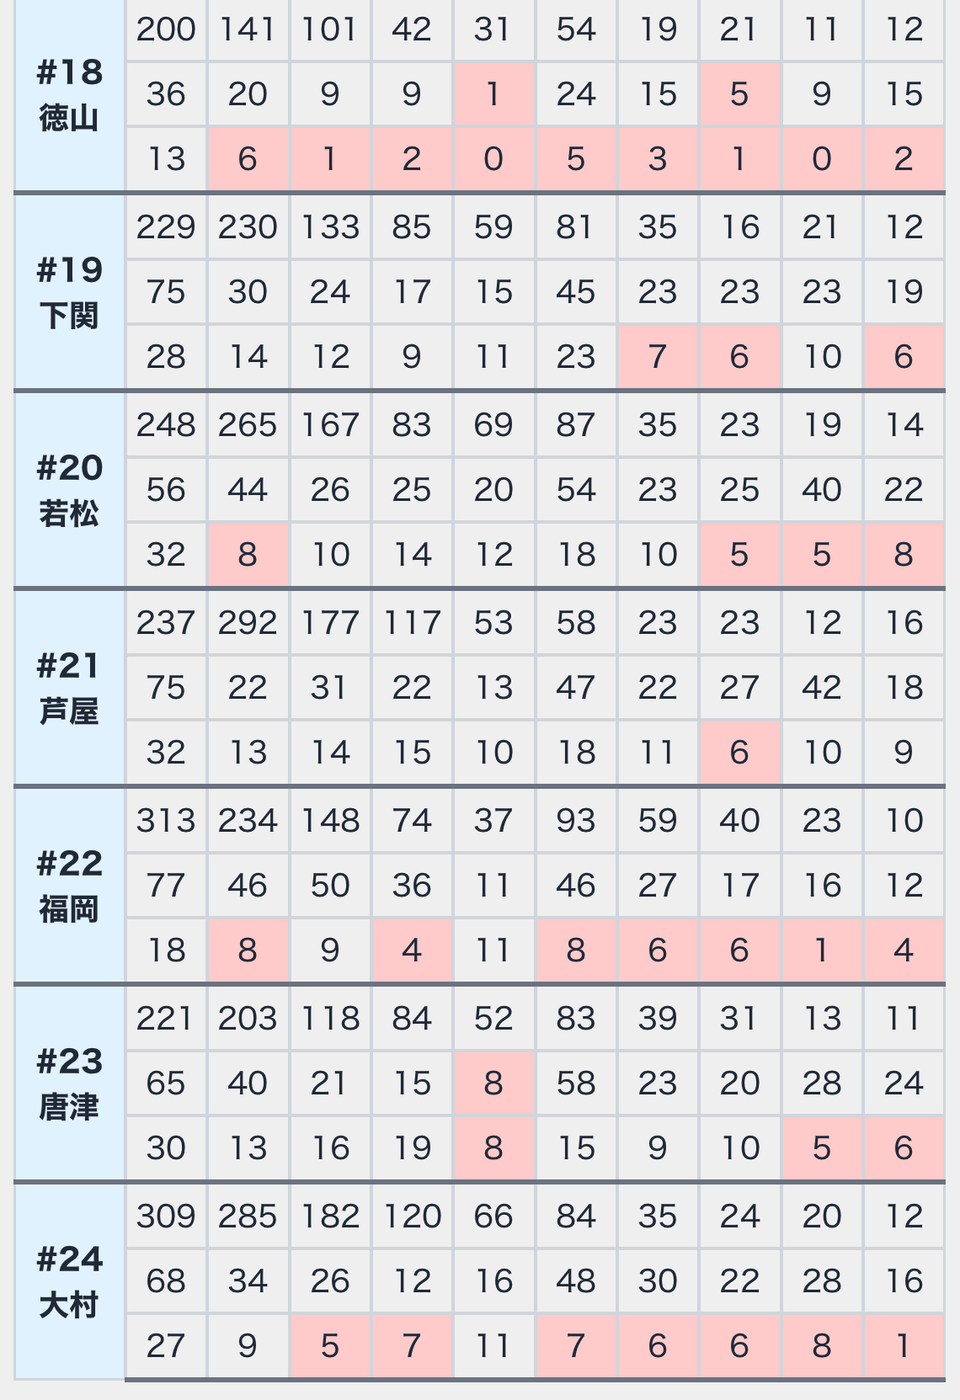
旧サイトには、「特徴量データが各クラス何件あるか」をモニタリングできる画面を作成していた(現サイトでは存在しない)。
表は 24場 × 30クラス。列の意味は c12 → 1-2、c56 → 5-6 の 2連単の組合せのことである。そして、ピンク = 件数が足りないクラスだ。 表から状況がうかがえる。
- このスクショのタイミングだと、徳山(#18)が壊滅的だ:
- 3行目
c51..c65= 13 / 6 / 1 / 2 / 0 / 5 / 3 / 1 / 0 / 2 →c56(5-6)とc64(6-4)が 0件。c51=13 以外の9クラスすべてがピンク - 2行目も
c36=1 /c43=5 がピンク - → 30クラス中 11クラスが学習に足りる数ではない。この場のモデルは19クラスしか予想が出せない
- 3行目
- 傾向として: イン(1コース)が強い水面ほど外枠の組が出ないのでデータが足りていない。
- 戸田 = ピンク2つだけ(
c63=5 /c64=8)→ 外枠の組もちゃんと出る「荒れる水面」 - 徳山 = 3行目がほぼ全滅(
c56=0 /c64=0)→ イン天国で外枠の組が発生しない - 福岡 = 3行目に7つ(
c52=8 /c54=4 /c61=8 /c62=6 /c63=6 /c64=1 /c65=4)
- 戸田 = ピンク2つだけ(
過去データの量を見るだけでも、場の違いが現れていそうだが、上述は2024年8月頃の話なので参考にしないほうがいい。
スクレイピング再び
再度同じ話をする必要はないだろう。僕は、足りないクラスのデータを補うため、過去データのスクレイピング(Episode.1参照)を数週間することになった。
実は、現在稼働している予想システムのモデルでは、30クラスのためのデータを揃える必要はない。30クラスの予想をしていないからだ。しかし、費やした時間に無駄はなかったと感じている。経験しているのとしていないでは大違いだ。
2026年現在のモデルに落ち着くまでに、ここからさらに1年半の時間がかかる。
AWS のコスト
2つの PyTorch 系モデルを動かしたことにより、この当時の課金はそれなりの額だったと思う。しかし、AWSの課金記録は 14ヶ月以内のものしか残っておらず、2024年の記録がない。
前回書いたとおり、僕は Lambda ベースでモデルの学習をコーディングしたために、GPU を利用していない。そのぶん計算時間がかかった。よく Snowflake や Databricks などのプラットフォームで機械学習系の話を聞くと、学習するデータ量が多い場合、GPUを使ったほうが利用単価は高価だが、学習時間が短くなるぶん運用費用全体は安くなる損益分岐点があると言われる。たしかにそうだろうが、ダイアナボートはそんなコマーシャルな規模ではない。
ざっくり古いコードと設定を解析して AIに概算させてみると、$100〜150/月という感じだ。
- Lambda: 約$60/月(ほぼタイムアウト一杯まで学習し Optuna 保存)
- EFS: 約$60/月(保存は12GB程度だったが、読み書きが多い)
- DynamoDB, Step Functions, Amplifyなどその他: 約$30/月
研究で複数のモデルを比較したりすると、$180ぐらいかかった月もあったようだ。時間としては、前日にレースが開催されたレース場のモデルは毎晩追加学習していたため、夜間の数時間を費やしていたが、翌朝の予想には間に合っているという状況である。当時はかかるコスト以上の夢があったのだ。
現在は非常に低いコスト運用をしており、学習時間も短い。実際のログもあるが、後のエピソードで話そう。
Episode 06 まとめ
今回は少し長くなったので、まとめておく。失業という特殊なイベントの最中、当たらない大穴予想だけに頼るのをやめ、2連単予想をベースとした3連単の予想モデルを導入した。今回のエピソードでは現在の状況にも言及しつつ、以下について話した:
- 会社都合で失業したら、離職票を催促して、ゲットしたらハローワークに走れ!
- クラス分類の数に応じて、追加の学習データが必要になることがある
- ボートレースでは、クラスに重みを付けず自然な分布のままのほうが、良い結果が出ている
- 何度も同じようなことを繰り返しているが、今思えば、無駄なことはなかった
少々、失業の件を思い出して感傷的なまとめかもしれない。
次回は、TabNet モデルの精度、フロントエンドについて記録しておこうと思う。3連単予想を追加したことで、それなりの画面が必要になってきたのだ。
つづく。
関連情報
- 雇用保険の具体的な手続き(ハローワークインターネットサービス) 厚生労働省離職票を持ってハローワークで求職の申込みをするところから、受給資格の決定・待期・認定日までの流れ。本文で「その日に手続きを」と書いた手順の公式案内。
- 基本手当について(ハローワークインターネットサービス) 厚生労働省いわゆる失業保険(基本手当)の受給要件、所定給付日数、基本手当日額の上限。会社都合の場合(特定受給資格者)の扱いもここ。
- LightGBM(公式ドキュメント) Microsoft決定木ベースの勾配ブースティングライブラリ。本文で DeepSAD と同じ「大穴かどうか」の二値分類を試した道具。
- TabNet: Attentive Interpretable Tabular Learning Sercan Ö. Arık, Tomas Pfister(Google Cloud AI、AAAI 2021)TabNet の原論文。表形式データ向けの深層学習で、どの特徴量を見るかをステップごとに選ぶ Attention 機構を持つ。
- pytorch-tabnet DreamQuark本文で実際に使った TabNet の PyTorch 実装(`TabNetClassifier`)。