
目次
本日は 2026年11月2日。バイブコーディング時代の書き始めの日である。
前回の丸亀ボート観戦の続きで、オープニングは高松で食べたうどんの話をしようと考えていたのだが、うどんは写真のみにしておく。実は今朝、僕はサイトのバグFIXを久々に行ったのである。午前7時、レース情報のスクレイピングで本家から403が返り、156レース中123レースの情報が取得できず、多くの場で予想が表示されない問題が発生した。
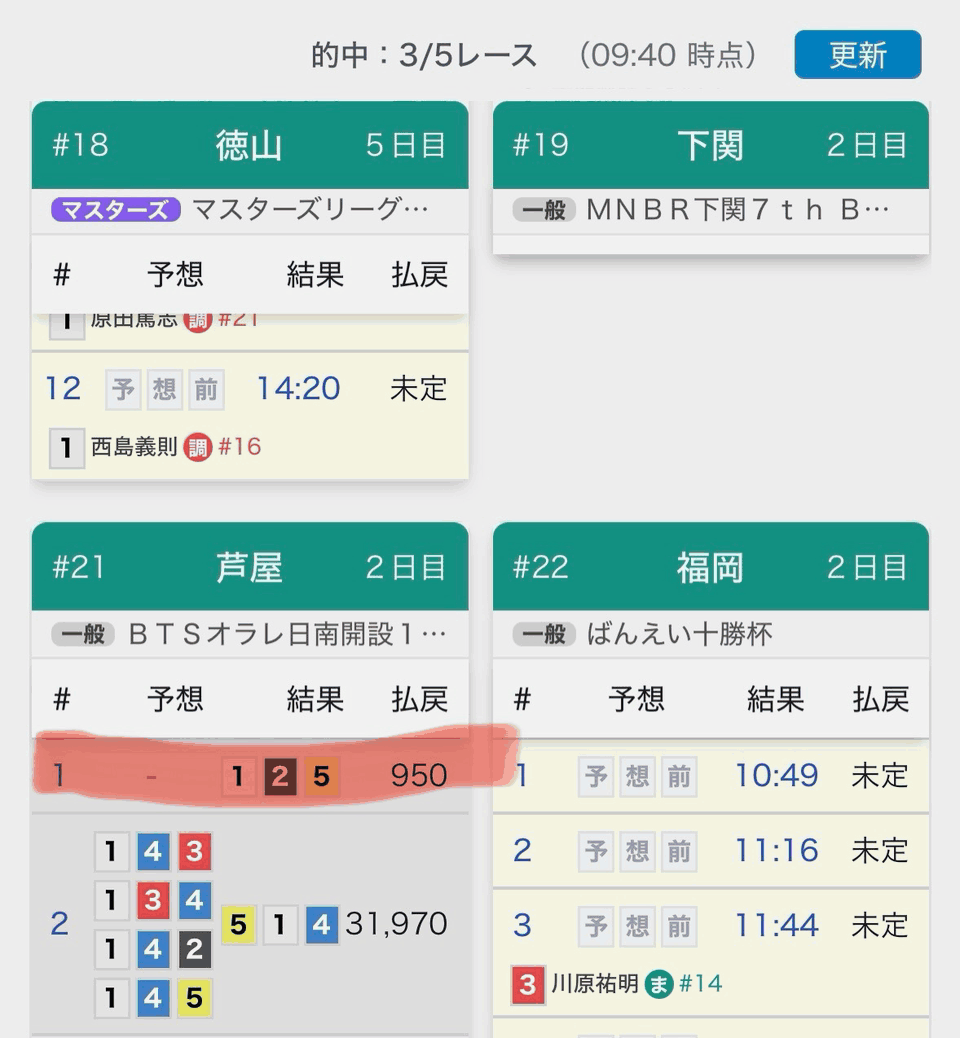
これまでにも天候などの直前情報、オッズ情報の取得で同じ403が発生したことがあるが、僕は都度リトライコードを組み込むなどの対応を行ってきた。しかし、これまでレース情報取得には問題がなかったため、リトライコードの組み込みを見落としていたのだ。
ただ一言、
「すべてのスクレイピング関連コードには、データ取得に問題が発生した場合のリトライ処理を組み込むこと。」
と言えていれば、今朝の問題は発生しなかっただろう。
どのコーディングAIを使うにしても事前にこのようなルールを決めて教えておくことで、朝の貴重な時間を無駄にすることがなくなる。
ただ、正直に話すと、僕は都度問題が発生したときに問題を分析し修正するほうが性に合っている。無駄なコードが少なくなるし、システムにも愛着が湧く。時間を費やして起こりうる事を想像し、可能なかぎり予見して、準備して作業を進めるやり方もあるだろう(そのように開発しなければならないシステムはもちろんある)。だが、そもそも抜け漏れは絶対ある。
問題をすぐにリカバリできる開発環境を作ること。そして、やりたいことがすぐに実現できること。それが優先だ。さて、システム再構築の話に入る。
2025年の年末
本業も再就職して1年が過ぎ、僕は落ち着いてダイアナボートの現状を分析できるようになる。Episode.8でも書いたが、作り直しを決断した要因は大きく2つある。
- 手動でのコード更新・管理が煩雑になり、改善・研究活動に手間がかかりすぎる
- 運用コストがかかりすぎ(月 $170〜180 前後)、リターンもないのに!
本業でもAIコーディングの活用が進み、プロトタイプの作成にも慣れてきた。当時よく使っていた Claude Code をそのまま採用し、正月休みに予想サイト再構築の計画を実行したのだ。
計画
再構築の計画にあたり僕が先に決めたことは多くはない。
- クラウド環境は AWS のまま: 蓄積したデータが移行しやすいだろうから
- GitHub 上でコードも設定もすべて管理する: 旧システムでは AWS Step Functions、EventBridge などの定義が変更管理されていなかった
- Spec Kit※1 を使う: 言葉ですべてをAIに指示する上で、非機能要求の漏れが少なくなりそうだ
- 学習モデルはコスト優先で選択する: ジャケ買いはしない。精度が同じなら PyTorch 系にこだわる必要はない
- Claude Code でのメンテナンスを前提: 手動では各AWSコンポーネントの設定は行わない。デプロイを含め手動設定を皆無にする
旧 Lambda・テーブルは捨て、スクレイピングは書き直し、約51万件のデータは再利用する。
とにかく重要なのは、モデルの改善作業、つまり新しい予想のアイデアをすぐに取り入れることができること。そしてコスト削減である。
正月休みの主なタスク
| 日時 | 主な履歴 |
|---|---|
| 2025-12-26 14:34 | GitHub に新リポジトリを作成(README など3ファイルだけ) |
| 2025-12-27 22:19 | 仕様書一式をコミット。ここからコミットに Claude Code の署名が入る |
| 2025-12-27 22:40 | Phase 1-2: プロジェクト構成・インフラ構築 |
| 2025-12-27 22:47 | Phase 3: 旧データの移行スクリプト作成 |
| 2025-12-27 23:22 | Phase 4: 予想を表示する最初の画面 |
| 2025-12-29 15:24〜16:58 | Phase 5〜7: 結果表示 / 的中率の統計 / 毎日のデータ収集 |
| 2026-01-05〜07 | 学習コンテナ、場ごとの学習、2段の3連単予想 |
| 2026-01-10 | dianaboat.com を新システムに切り替え、新環境への移行完了 |
移行が終わった 1月10日までの16日間で99コミット。コミットがあったのはそのうち9日で、12月30日から1月4日までの正月の6日間は一度もコミットしておらず、僕ものんびりと過ごしていたのだろう。
Spec Kit
Spec Kit とは、GitHub がオープンソースで公開している仕様駆動開発(Spec-Driven Development)のためのツールキットである。コーディングAIにいきなりコードを書かせるのではなく、まず「何を・なぜ作るか」を仕様書に書く。そこから設計、タスクの分解と段階を踏んで実装に入る、という作法を AI に仕込む道具だ。
面白いのは、段階ごとに AI のほうから足りない情報を補う質問が返ってくることである。「過去データの保持期間は?」「予測結果の表示形式は?」と聞かれ、答えるたびに仕様書・設計書・タスク表が Markdown で積み上がっていく。仕様書のひな形には成功基準や想定外のケースを書く欄もある。
言われたことしかやらない AI と、言い忘れる僕。その隙間を埋めてくれるツールと言えるだろう。
2026年11月時点
ただ、この1年で状況はずいぶん変わっている。Claude Code には「プランモード」※2があり、コードに触る前に AI が調べて計画を立て、人が承認してから実装に入る。
GitHub Copilot にも 2026年1月にプランモード※3が入り、Cursor※4 や OpenAI の Codex※5 にも同じような機能がある。AWS の Kiro※6 に至っては、要件・設計・タスクを書く流れそのものが開発環境に組み込まれている。
つまり Spec Kit が仕込んでいた「書いてから作る」作法は、もはやコーディングAIの標準装備になりつつある。実際、サイトの再構築後は、新しい機能やアイデアの追加には主にプランモードを利用している。
最初の仕様
ダイアナボートのような予想サイトやアプリなどを AI を使って構築してみたいという方にとっては、最初に僕が何を Claude Code に(Spec Kit のコマンドを通じて)伝えたのかを知りたいと思うだろう。初回の原文が記録されていたのでそのまま記載しておく。
2025-12-27 16:51 /speckit.specify に貼り付けた原文
・ボートレース学習データ収集機能
- https://www.boatrace.jp/ から、当日のレース開催情報(全24場のうち開催予定のレース)を早朝に取得
- 当日の各レース結果をレース後随時取得
- 取得した各レース結果データをデータベース(AWS DynamoDB)に格納
- 格納データ:各レースの出走表、オッズ、直前情報、レース結果

・ボートレース結果予想MLモデルの学習機能
- 格納された AWS DynamoDB テーブルの過去レース結果情報を Feature Engineering して表データとして AWS S3 に格納
- 複数の表データ分類モデルを構築し比較が行える構成とするが、最初は以下の1モデルを利用
- STEP-1
    - S3 上のFEデータを利用して、CatBoost(class_weights) モデル + macro-F1 指標で学習
    - 30クラス分類(ボートレース6枠の2連単)を行い、さらに 6 クラス分類(3着目を予想)して3連単を予想する
- STEP-2 (後日)
    - レーサー毎の調子の上向き下向きを予想して、CatBoost への入力データとする
    - レーサーの開催試合内でのレース状況(通常レースは開催試合毎に数日にわたり実施され、その総合得点で優勝を争う)、例えばすでに最終レースに進むことが決まったレーサーは無理はしない?など様々な実験をしたい。
- 学習の頻度は毎日夜間バッチで行う

・ボートレース結果予想機能
- 学習したモデルを利用して、当日開催の各レースの予想を DynamoDB に出力する
- フロントエンドで DynamoDB 上の予想結果を表示
- フロントエンドでは随時レース結果が確認できる
- フロントエンドでは過去の的中率などが確認できる
- フロントエンドのデザインは、既存サイトのUIデザインを再利用する

・その他の一時的な機能
- 過去のレース結果データを保持した旧DynamoDBテーブルからの新DynamoDBテーブルへのデータ移行

・利用できるリソース
- データをクローリングする Lambda 関数のサンプルコードが存在
- 過去データを保持している DynamoDB Table
- 既存サイトで利用しているフロントエンド実装
上記 specify コマンドでは主にシステムで実現したい機能を説明している。このコマンドがメインパートではあるが、再構築初日と2日目あたりに僕が何を行っていたかも細かく紹介しておこう。
Claude Code とのやりとりの記録
12月26日(金): 相談と準備、そして constitution
| 時刻 | やったこと(「」内は僕の入力) |
|---|---|
| 14:34 | GitHub に新しいリポジトリを作成 |
| 14:36 | /init で Claude Code にリポジトリを読ませる |
| 14:41 | 最初の相談。「この既存テーブルの情報を利用して、ボートレースの予想システムを新たにスクラッチから開発することになりました。…AWS CDKなどを利用して1つのgithubリポジトリ上で管理するようにしたほうがよいでしょうか?」 |
| 14:44 | 前提を補足。「クローリングシステムも今回のスコープです。」「CDKは TypeScript がよいです。」「モノレポにしたいです。個人開発です。」 |
| 14:45〜14:54 | AWS への接続設定を確認・修正 |
| 14:55 | 「既存環境を確認してみてください。その上で、speckit を利用してきちんと開発を進めていきたいです。ただし、絶対DynamoDBは削除や変更はしないでください。」 |
| 15:00 | 「Astro にする必要はないと考えており、react+tailwind だけでよいと考えています。」「独自の Machine Learning Modelを構築するため、Python がよいと考えています。既存のGenerative AI は利用しないのです。」 |
| 17:11 | 「DynamoDB はどのように移行することになりそうですか?」 |
| 17:13 | 「利用するのは、Raw という名前がついた過去のレースの生データのみです。」新しいテーブルを設計する案に決め、Spec Kit のインストールを頼む |
| 17:18 | 「/speckit.constitution にはどのような情報を渡すのでしょうか?」 |
| 17:20〜17:35 | AWS のドキュメントを引ける MCP サーバーなどを設定。動かないものは削除 |
| 17:35 | /speckit.constitution(開発の原則づくり) |
| 17:44 | AI が出した5つの原則案から、Clean Architecture / Observability / Simplicity (YAGNI) の3つを選ぶ |
| 17:45 | 「次のステップは?」(この日はここまで) |
12月27日(土): specify から implement まで一晩で
| 時刻 | やったこと(「」内は僕の入力) |
|---|---|
| 16:51 | /speckit.specify に上で紹介した仕様を貼り付け |
| 16:58 | 「1つ追加させてください。各レースの予想には、天気情報(風速などを含む)が必要なため、1つ前のレース結果に含まれる風速、波高などを入力とする必要があるため、直前に予測がフロントエンドに表示されることになる。」 |
| 17:02 | /speckit.clarify。仕様の足りないところを AI が5つ質問してくる |
| 17:03 | 質問1: フロントエンドのアクセス制御は? →「A」(認証不要・公開アクセス可) |
| 17:04 | 質問2: アラート通知先は? →「B」(Amazon SNS 経由で通知) |
| 17:05 | 質問3: 過去データの保持期間は? →「C」(2年間) |
| 17:06 | 質問4: ML モデルのバージョン管理は? →「B」(直近7日分を保持) |
| 17:11 | 質問5: 予測結果の表示形式は? →「上位4位まで」(3連単4点) |
| 17:12 | /speckit.plan(設計) |
| 17:24 | 「既存テーブルの構造を踏襲する必要はない(データを移行したいです)のですが、既存テーブルに保持しているデータは勿体ないのでもれなく流用したいのです。」 |
| 21:55 | 選手の時系列データのテーブルは STEP-2 で使えると伝える |
| 21:56 | /speckit.tasks(タスク分解) |
| 21:59 | 「ちょっとまってください。」既存のクローリングは「このまま利用したいとは思っていません。なるべく最適化、シンプル化して利用したい」が、「1レース毎のレース情報・結果のクローリングの詳細は長く動いているためそのまま利用できれば安全だと考えています。」 |
| 22:06 | 「今回、CDKですべてデプロイできるように実装していきたいのですが、既存環境は現在稼働しているため、変更は絶対にしないでください。」学習は「Lambdaではなく、AWS Batch などで学習ができる環境がよいようにも思います。」 |
| 22:14 | 「既存サイトのフロントエンドは、Astro を利用してSSGになっていますが、リアルタイム性(レース結果をすぐに参照したい)という観点から、SSGを利用する必要はありません。」「dianaboat.com を入れ替えたいと思っています。」「ステージング環境は必要ありません!」 |
| 22:19 | ここまでの仕様書一式をコミット |
| 22:20 | /speckit.implement(実装開始) |
| 22:27 | 「クローリングしたRawデータを保持しているテーブルは stack を destroy しても削除されないように念の為しておいてもらえますか?」 |
| 22:36 | 「Python は 3.12 以上にできませんか?」 |
| 22:38 | 「コミットしてから Phase 3 へ進んで」(22:40 に Phase 1-2、22:47 に Phase 3 をコミット) |
| 22:54 | 「ちょっとまって、フロントエンドは既存のデザインを踏襲したいのですが、大丈夫ですか?たとえば、このような感じです。https://dianaboat.com/」 |
| 23:22 | Phase 4(最初の画面)をコミット |
これだけで、一旦は画面までは実装できていたようだ(もちろん、いろいろな微調整は続く)。フロントエンドに関していえば、完全なスクラッチではなく既存のコードを流用している部分があると考えられる。
履歴からみえる状況
会話の履歴を辿ってみると、12月26日に再構築を始める前に、僕はある程度のリサーチを行っていたことがうかがえる。例えば以下のポイントである。
- 初期学習モデルを CatBoost※7 と指定している
- クラスの重み付けを利用する意思があった(手組み時代に付けないほうが良いとわかっていたのに謎である。今も使っていない。)
- なぜか、macro-F1 指標を指定している(今は多クラスの AUC / log loss)
残念ながら、これらの詳細な記録は残っていなかった。おそらくローカルマシンでの実験やコストを重視した調査から導いたものだと考えられる。
まとめ
本エピソードでは、コーディングAIを利用したバックエンド・フロントエンドを含めたサイト全体の再構築のさわり、最初の2日間について詳細に履歴を辿ってみた。次回以降のエピソードでは残りの初期再構築タスク、既存データの移行と AWS DynamoDB テーブルの再設計について見ていきたい。
つづく。
関連情報
- Spec Kit GitHubAI コーディングエージェントに仕様駆動開発の手順とテンプレートを与えるオープンソースのツールキット。
- Analyze before you edit with plan mode(Claude Code ドキュメント) AnthropicClaude Code のプランモード。ファイルを変更せずに調べて、変更案を出す。
- GitHub Copilot CLI: Plan before you build, steer as you go(GitHub Changelog) GitHub2026年1月21日、Copilot CLI にプランモードが入ったときの告知。
- Plan Mode(Cursor ドキュメント) Cursorコードを書く前に、詳しい実装計画を作るモード。
- Developer commands(OpenAI ドキュメント) OpenAICodex CLI のコマンド一覧。/plan でプランモードに切り替わる。
- Specs(Kiro ドキュメント) Kiro(AWS)要件(requirements.md)・設計(design.md)・タスク(tasks.md)の3つの文書を書いて進める、Kiro の仕様機能。
- CatBoost(公式ドキュメント) Yandex決定木の勾配ブースティングによる機械学習ライブラリ(オープンソース)。いまのモデルも CatBoost で作っている。