
目次
2026年10月前半、僕は瀬戸内海をめぐる旅に出ていた。島めぐり、しまなみ海道、うどんを楽しむスケジュールだったのだが、ちょうど丸亀ボートが開催されている期間にあたり、レース場に立ち寄って1レースだけ観ることができた。
今治から高松へ向かう途中、かたちのキレイな飯野山の山容を右手に見ることができる。そのあたりを左に瀬戸内海方面に向かうと BOAT RACE まるがめ(まるがめボートレース場)がある。
全国的になのだろうか。最近の平和島もそうだが場としては建て直されたばかりの見た目だった。そして駐車場が異様に広い。駐車場からはエスカレーターを使って入口へと道を渡っていく。
他の場と同様に入場料 100円を投入し入場。平日なので人は少ないが、女性客が結構いたように記憶している。
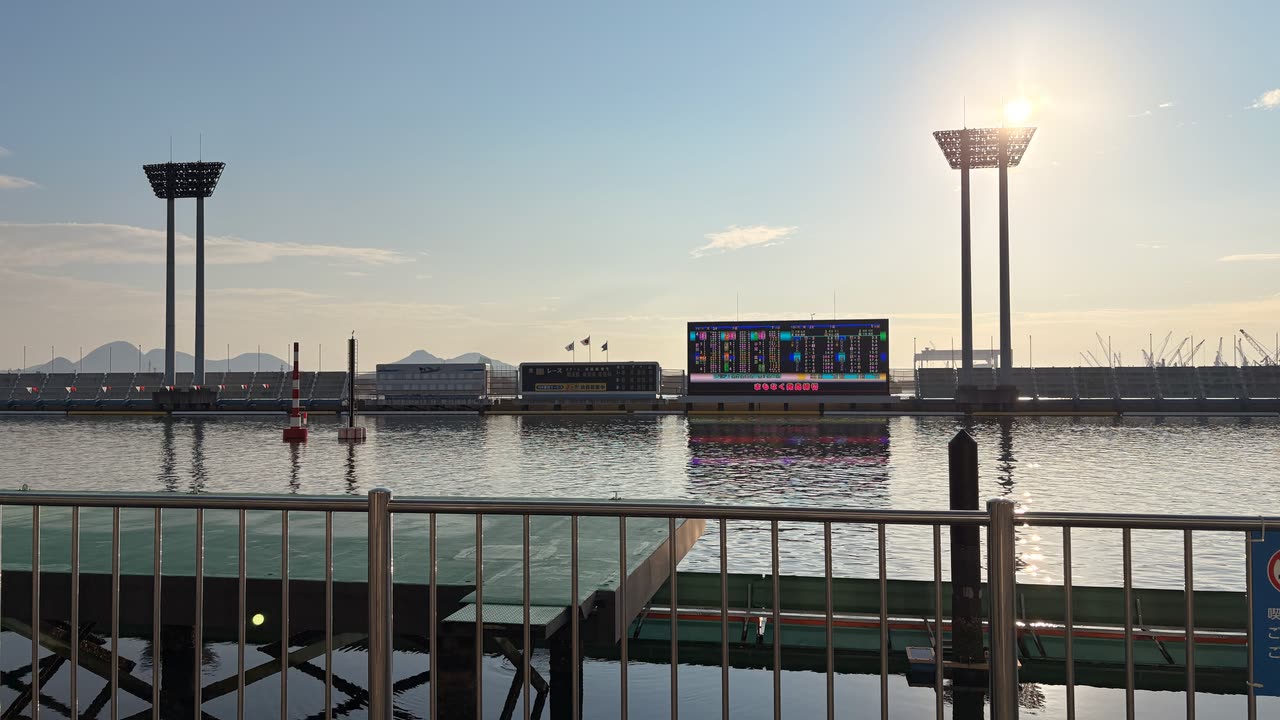
正面からはすこし離れているのだが、観戦ポイントとして僕がオススメしたいのは1マーク正面からのポジションである。このアングルから観戦できる場は他にあるのだろうか。ターンのアクセルさばきがよくわかる。本当にオススメである。
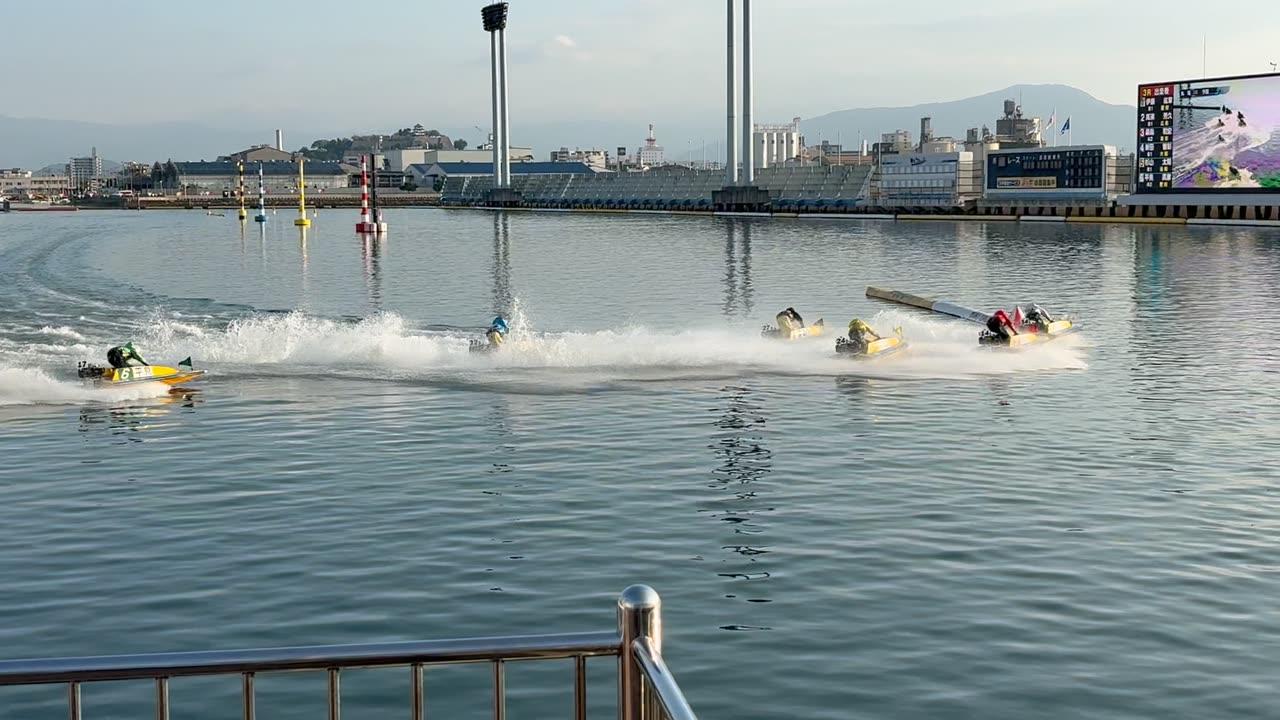
もちろん、僕はわがダイアナボート予想にしたがって舟券を購入した。が...、今回は的中とはならなかった。無念である。
さて、本エピソードにもどる。今回は第一部 手組み時代のしめくくりである。これまで紹介してきた 2023年12月〜2025年7月のボートレース予想の実装を総括する。
第一部 手組み時代のまとめ
これまでのエピソードで紹介した落とし穴や、学んだ事についてまとめる。結局、大穴予想はうまくいかなかったのだ。
第二部では、スクラッチから3連単予想に特化した予想システムを作り直すエピソードになるのだが、関連する最近の話題も少しだけ追記しておく。
データ収集について(Scraping)
- 本家 HTML は意味のある名前を持っていない。
is-fs11is-lineH2のような見た目用の class と、rowspan="4"+<br>で1選手を4行に割った表。パースが辛く、ページの構造変更もたまにある事に注意。ページの変更は本家お知らせセクションの一覧→サイト更新タブに掲示される
→ Episode.1「泣ける」本家ページ構造 - HTML の生データを保存しておけ。主観で抽出項目を絞った結果(大穴しか考えておらず選手番号・体重・年齢を捨てた)、約80時間の再収集を3回やった
→ Episode.1「無駄な収集を行わないために」 - 本家に負荷をかけない。夜間・低速(1分に5レース程度)で取ると、24場×1,000レースで約80時間。深夜6時間ずつ回して2週間かかる
→ Episode.1「本家サイトに負荷はかけないよう」- 後日談:2026年6月27日、Lambda の送信元 IP が boatrace.jp から断続的に 403 を受けた(同じ URL は別 IP からなら 200)。心配していた「IP 単位のレート制限」は実在した。403 はレース中止ではない(中止は 200 でオッズが空)
- 天気は「予想する時点で取れるか」がすべて。結果ページの天気は事後の情報。1つ前のレースの結果で代用しても、1R はどうする? 結局、気象庁の予報 API を使い、場と予報区の対応表を手で書いた
→ Episode.2「環境系データについて備忘録」- 直前情報ページ(
beforeinfo)に気づくのが遅れた。天気・風・波のほか、展示タイム・展示ST・進入コース・当日体重・部品交換・安定板・進入固定までここに出る(いまの本番はここから取っている)
- 直前情報ページ(
- 出走表・結果以外の情報源(あまり知られていないもの)
- 選手の期別成績 = ファン手帳データ(半年ごと・固定長テキスト)
→ Episode.2「例1: 74列に絞る」 - 潮位 = tide736.net(天文潮位の計算値なので、過去の日付でも取れる)
- 公式のコンピュータ予想(PC予想)も収集し、自信度を特徴量に入れていた。2026年7月に精度を実測すると、PC予想の本命(1点目)の3連単的中率は 4.14%で、1-2-3 決め打ち(6.81%)にも負ける(いまのモデルは 7.81〜9.28%)。「公式の予想を特徴量に」は誰でも考えるが、元の予想がそもそも弱い
- 選手の期別成績 = ファン手帳データ(半年ごと・固定長テキスト)
- データ不足は、予想するクラスを増やした瞬間に来る。2連単30クラスにしたら少数クラスが枯れ、過去分のスクレイピングを数週間やり直した
→ Episode.6「スクレイピング再び」 - 位置指定のセレクタ(
nth-child)は開催中にずれる(後日談)。締切が繰り下がると「締切予定時刻が変更されております」の告知ブロックが表の前に1つ挟まり、決まり手と3連単人気が約8%欠けていた。2026年9月に発覚し、3,443件を取り直した
参考までに、いまの本番システムが読んでいる本家のページは次のとおり。
racelist(出走表)/beforeinfo(直前情報)/raceresult(結果)odds3t(3連単オッズ)/odds3f(3連複オッズ)pay(払戻一覧 = その日の開催場とレースが1ページで分かる)- スマホ版の
monthlyschedule(月間スケジュール = グレード・開催名)
特徴量について(Feature Engineering)
- 出発点は生の136列(1艇21項目×6艇 + 環境8 + キー2)
→ Episode.2「名前が思い出せない」 - 目的変数(target)を決めるのがいちばん難しい。
san_ren_tan_pay > 36000/ 12,000 / 48,000 … 閾値を動かすと「異常」の割合が 2〜14% で揺れる。これはもう異常検知ではなく、不均衡な二値分類だ
→ Episode.2「特徴量エンジニアリング」 / Episode.4「異常の定義」 / Episode.4「異常検知 vs. 分類」 - 数値化に正解は無い(平均STは逆数か平均との差か / 級別 A1→0.9 … / 新人の欠損をどう埋めるか)。試すしかなく、手で書くと時間が溶ける
→ Episode.2「特徴量エンジニアリング」- 後日談:欠損は 0 で埋めず NaN のまま渡すのが正解だった。2026年6月、
fillna(0)をやめたら1着予想の的中率が 0.49ポイント上がった。「初日の節内成績 = 0」が「1着より上」に読まれていた
- 後日談:欠損は 0 で埋めず NaN のまま渡すのが正解だった。2026年6月、
- 列を減らす方向は効かなかった。74列に絞っても、内3艇/外3艇の平均で22列に畳んでも、全然ダメだった。今は削らない(いまの1着モデルは 2026年6月時点で248列)
→ Episode.2「例1: 74列に絞る」 / Episode.2「例2: 22列に畳む」 - オッズを特徴量にする誘惑(3連単オッズ120列だけの特徴量を作って止まった)。今もオッズは特徴量に入れていない
→ Episode.4「異常の定義」 - 予想する時点に存在しない情報を混ぜない(結果ページの天気、確定オッズ)。学習と予想でデータがずれる話は第四部で詳しく書く
- 夜 = 結果収集 → 特徴量 → 学習 / 昼 = 直前情報 → 特徴量 → 予想、というパイプラインの形
→ Episode.2「パイプライン」 - 古いデータの重みは下げる、クラスの重みは付けない
→ Episode.6「データ不均衡への対応」
モデル作成について(学習・評価・動かす環境)
- ノーコード(SageMaker Canvas)は、24場ぶん同じ設定をする時点で挫折
→ Episode.3「ノーコードというノーサンキュー」 - 場ごとにモデルを作るという仮説を立て、ハイパラまで場ごとに
if/elifで分岐して、7場目で力尽きた
→ Episode.3「24会場の壁」 / Episode.4「24場の罠、再び」- 後日談:2026年7月に全場を1つのモデルにまとめたほうが良いことを測って本番化した(第三部で書く)
- モデルを名前でジャケ買いしない(DeepOD = 異常検知ライブラリだから DeepSAD)。しかも PyTorch は Lambda に載らない。展開後 250MB の制限は EFS に逃がし、15分の実行時間の制限は自分を呼び直してしのいだ
→ Episode.3「Lambda レイヤーの罠」 / Episode.3「Lambda 実行時間の罠」 - 評価指標を確かめる。accuracy で選ぶと「全部賭けない」が84%正解になる
→ Episode.5「評価指標の勘違い」- AUC も信頼区間で見る(0.4837 / 0.5604 はどちらもコイン投げと区別がつかない)
→ Episode.4「コイン投げ」
- AUC も信頼区間で見る(0.4837 / 0.5604 はどちらもコイン投げと区別がつかない)
- スコアは保存する。
printしただけでロググループごと消えた(2026年にモデル本体から測り直した)
→ Episode.4「コイン投げ」 - ハイパラは手で振らず Optuna に。日付で batch_size を変える自作探索は、毎日データが違うので比べられない
→ Episode.5「batch_size パラメータ」 / Episode.5「Optuna」- 後日談:2026年10月に同じ罠をもう一度踏んだ。Optuna の「歴代ベスト」が、検証データがいちばん簡単だった7〜8月の夜の試行に凍結し、2〜3か月半ぶんの毎晩の探索が反映されていなかった(「その夜の試行だけで選ぶ」に修正)
- クラスを増やすと少数クラスが枯れる。2連単30クラスで児島 1-2=296件 / 6-5=3件。徳山はイン天国で 5-6・6-4 が0件。19クラスしか予想できない
→ Episode.6「学習データが足りない」 / Episode.6「当時のデータ状況」 - クラス重み(balanced / Focal Loss)は付けないほうが良かった(いまも付けていない)
→ Episode.6「データ不均衡への対応」- この結論が出た日も分かる。2025年2月15日の
_nw系(type5_nw/type5_30_nw)が、compute_class_weight('balanced')と FocalLoss を外して普通の交差エントロピーにした版(nwはおそらく no weight の略) - 時間の重み(直近3か月を1.5倍 など)も 2025年3月に入れて4月に外している。いまのモデルは時間減衰を使っている(第三部で書く)。当時は外した道具が、2026年に形を変えて戻ってきた
- この結論が出た日も分かる。2025年2月15日の
- 学習コスト:Lambda + EFS 構成で $100〜170/月(実際の請求の内訳は後述)。個人サイトの運用費としては高すぎだ。これも第二部の作り直しの理由となる
→ Episode.6「AWS のコスト」 - 予想は「当たる」より先に「答え合わせする画面」が要る(的中率・損益・AUC の推移)
→ Episode.7「デザイン」
手組み時代のモデルの変遷
バックエンドのコードは、最初の10か月は git に入れていなかった。2024年10月末にまとめてコミットしたあとも、12月までの3回きりで、2025年以降の変更は一度も git に入っていない。この回を書くにあたって、いまも AWS 上に残っている Lambda から当時のコードを取り出して確かめた。
何を予想し、何で予想したか
世代を追うと、「予想」そのものが変わっていくのが分かる。
| 時期 | 呼び名 | 予想対象 | モデル | 買い方 | 1レース |
|---|---|---|---|---|---|
| 2024年3月〜 | 大穴(type0〜type4) | 荒れるか(3連単の払戻が12,000〜48,000円を超えるか) | DeepSAD(LightGBM とも比較) | 3連単120通り全部 | 12,000円 |
| 2024年9月〜 | 800 | 1着と2着の組(順不同の15クラス) | TabNet | 大穴モデルが選んだレースだけ。組{a,b} → a-b-全 / b-a-全 | 800円 |
| 2024年11月〜 | 800AR | 1着→2着(順番ありの30クラス = 2連単の全30通り) | TabNet | 全レース。上位2組 × 3着全流し = 8点 | 800円 |
| 2024年11月〜 | 大穴(type5) | 荒れるか(12,000円を超えるか) | TabNet の二値分類 | 1場1日1レースまで × 120通り | 12,000円 |
| 2025年2月〜 | 400AR | 3着(800AR が出した1・2着を入力にした2段目) | TabNet | 上位2組 × 3着の上位2艇 = 4点(最終形) | 400円 |
- モデルはずっと場別(24場それぞれに1つ)だった。全場を1つにまとめるのは2026年7月(第三部で書く)
- 800AR・400AR の「AR」は全レース(All Races)のこと。大穴モデルが選んだレースだけで予想していた 800 に対して、全レースで予想する版という意味だ
- 大穴モデルも、2024年11月の type5 からは TabNet の二値分類に置き換えている。DeepSAD を使っていたのは type4 まで
→ Episode.4「異常の定義」 / Episode.6「二兎の前のもう一匹」 - 成績はどれも「この買い方で投票していたら」というシミュレーションで集計していた
→ Episode.7「デザイン」
2連単とカスケード
2連単は、モデルとしては作っていた。1着→2着の順番つきで30クラスに分類する 800AR がそれだ。それまでの 800 は「1-2 と 2-1 を同じ組」とみなす15クラスだった。
ただし2連単は配当が低いので、買い方は3連単にしていた(組 × 3着全流し)。
→ Episode.6「もう一つの兎 - TabNet 3連単予想」
カスケードもやっていた。2025年2月からの 400AR が、「1・2着の組 → 3着」の2段構成になっている。
- 予想するときは、まず 800AR が1・2着の組を出し、その組を入力にして3着を当てる
- 学習するときは、800AR の予想ではなく実際の1・2着を入力に使う(いわゆる teacher forcing)。1・2着の艇番を one-hot(
first_lane_1..6/second_lane_1..6)にし、残った艇の最内・最外などの位置の特徴8個と一緒に足していた - 現在の最新のモデルも、学習時は実際の着順を入れる同じやり方だ。2025年2月の時点で、同じ方向に進んでいたことになる
運用の工夫(2025年)
- Optuna は週1回、学習だけ3日おき(2025年5月〜)。ハイパーパラメータの探索は毎週月曜に回し、それ以外の日は保存済みのパラメータで学習だけする。少しでもコスト削減をしたかった
- 直前予想(2025年6月〜)。レースの35分前に直前情報ページの風のデータ(風速・風向)を取得し、800AR → 400AR で予想し直す。Episode.2 で「直前情報ページに気づくのが遅れた」と書いたが、気づいてからはちゃんと使っていた
→ Episode.2「環境系データについて備忘録」
特徴量の列数の推移
| 時期 | 列数 | 中身 |
|---|---|---|
| 2024年1月 | 136 | 生データ全部(1艇21項目×6艇 + 環境8 + キー2) |
| 2024年1〜3月 | 74 / 91 / 22 | 絞る・6艇ぶん並べる・内外の平均に畳む |
| 2024年2月 | 122 | 3連単オッズ120通りだけ(学習まで行かず) |
| 2024年9月 | 86 | 800: 艇ごと13項目×6 + PC予想の情報 + 風速 |
| 2024年12月〜 | 139 | 800AR など: 艇ごと20項目×6(各項目に 6艇の中での相対的な優位 _rel_adv を足した)+ 風向17 + 風速 + PC予想の自信度 |
| 2025年2月〜 | 159 | 400AR の3着モデル: 139 + 1・2着の one-hot 12 + 位置の特徴8 |
- 800AR・400AR の世代(2024年12月〜)は、オッズ・選手ID・潮位を使っていない(潮位は2024年12月に外した)
- 6艇の中での相対的な優位(
_rel_adv)は、Episode.2 で悩んでいた「平均STの差が小さすぎて優劣がつかない」への、手組み時代なりの答えだった
→ Episode.2「特徴量エンジニアリング」
第二部(バイブコーディング時代)へ
手組みの限界 ― 作り直した理由
- モデル管理が煩雑:Lambda 89本 / Step Functions の定義 34本(うち
diana_boat_*が27本)。世代を上げるたびに fe / ml / predict の3点セットが増え、古い世代を消すのが怖い物量に - コードが4か所に散らばった(研究ノート / 本番 / フロント / 半年古いフロントのクローン)
- コスト:旧システムだけが動いていた最後の月(2025年9月)の請求は $167(税込)。その半分の $81.8 が EFS で、保存料は $0.74、残りはすべて読み書きの料金だった(約2TB/月)。PyTorch を Lambda に載せるために EFS に置き、Optuna の記録も EFS 上の SQLite に置いていた。保存しているのは数GBなのに、読み書きが月2TBに膨らんでいたのだ。ほかは Amplify $22.4(うち WAF $15、ビルド $7.4)、Lambda $11.6 など
→ Episode.6「AWS のコスト」- 作り直したいま(2026年9月)は、公開サイトを含めて $41(税込)。学習は AWS Batch に移して $5.7/月で済んでいる
次回からバイブコーディングによるボートレース予想システムの再構築へ話を進める。
つづく。